
Según un estudio de Buzzstream un 79% de los sitios de medios de comunicación en los EEUU y en Reino Unido están bloqueando 1 o más bots de IA.
Con esto quieren evitar que la IA utilice sus contenidos para:
- Entrenar los modelos de IA.
- Mostrarlos en las respuestas de IA.
- Citarlos en las respuestas de IA.
Quiero revisar si los medios de comunicación en el Ecuador también están bloqueando la IA vía robots.txt para que no tenga acceso a sus sitios web/sus contenidos online.
(Ojo, los archivos de robots.txt pueden cambiar. Los revisé por primera vez en abril. Ahora en mayo hubo algunos cambios).
Otra forma de bloquear la IA es a través de un CDN como Cloudflare. Esto no revisé.
Tabla de contenidos
Primicias
Primicias.ec no está bloqueando específicamente a las IAs mediante el archivo robots.txt.
El Universo
Tiene en su archivo de robots.txt ya directivas para bots de IA como:
- GPTBot (ChatGPT – OpenAI).
- ClaudeBot (Anthropic).
- Google-Extended (Gemini).
- PerplexityBot (Perplexity).
- CCBot (Common Crawl, una de las bases de datos más grandes para entrenar IAs).
Pero estos directivos están comentados con #. Así no están en funcionamiento. Significa que la IA todavía tiene acceso a los contenidos de El Universo. Pero están pensando en bloquearla.
Lo interesante es que hicieron recientemente un cambio en su archivo robots.txt y parece que copiaron por error el contenido de un archivo ads.txt al archivo robots.txt.
El Comercio
El Comercio es un caso interesante. Hasta hace 1 mes tenía la IA bloqueada en su archivo de robots.txt:
- GPTBot: Bloqueado
- Google-Extended: Bloqueado.
- ClaudeBot: Bloqueado.
- CCBot: Bloqueado..
- Applebot-Extended: Bloqueado (la IA de Apple).
- Meta-externalagent: Bloqueado (la IA de Facebook/Instagram).
Sin embargo, modificó su archivo robots.txt. Ya no aparecen los bloqueos de la IA.
Pero El Comercio usa Cloudflare para poder bloquear la IA.
Expreso
Expreso está bloqueando varios bots de la IA:
- GPTBot: Bloqueado.
- Anthropic-AI (bot antiguo) y ClaudeBot: Bloqueados.
- CCBot (Common Crawl): Bloqueado.
Pero no están bloqueando Perplexity, tampoco OAI-Searchbot.
El Telégrafo
Al igual que Primicias, El Telégrafo no menciona a los bots de IA que dominan el panorama actual. No aparecen GPTBot, Google-Extended ni Common Crawl (CCBot). Por lo tanto, estas herramientas pueden entrar y procesar sus noticias sin restricciones.
La Hora
En su archivo robots.txt da acceso selectivo a la IA de búsqueda. Permite la entrada a bots como:
- OAI-Searchbot.
- PerplexityBot.
- Claude-SearchBot.
Esto indica que La Hora sí quiere que la IA te responda usando sus noticias, siempre y cuando sea a través de motores de búsqueda que citen la fuente.
Pero están bloqueando los bots de IA de entrenamiento (implícito): Al no listar a GPTBot o Google-Extended en la sección de permitidos, y tener un Disallow: / para el resto del mundo (User-agent: *), están bloqueando automáticamente que modelos como ChatGPT o Gemini usen su contenido para «entrenar».
El Mercurio
Tiene, técnicamente, el sitio más amigable y abierto de todos los medios de comunicación.
Ecuavisa
Ecuavisa ha creado en su archivo de robots.txt una lista grande de bots a los que sí permite entrar, pero con condiciones.
Entre estos bots son:
- OAI-Searchbot (El buscador de OpenAI).
- PerplexityBot.
- Claude-SearchBot.
- ChatGPT-User (Cuando un usuario le pide a ChatGPT que visite un link específico).
- Bots de IA de entrenamiento.
Están bloqueando:
- /vipcontent/: Protegen su contenido exclusivo o premium (no sé exactamente lo que hay en “vip”).
- /*contenidos/ y /articulo/: Esta es la parte más extraña. Técnicamente, están intentando bloquear las rutas internas de sus artículos.
- /metadatos/: Evitan que las IAs lean la información estructurada detrás de las noticias.
Lo raro es que sus artículos no están en la carpeta “/artículo”. Así que la pregunta es: ¿por qué están bloqueando esta carpeta?
- Puede ser por error o puede ser porque copiaron el archivo robots.txt de otro sitio o así viene de su CMS preconfigurado.
- Pero también puede ser que estén intentando bloquear la ruta interna de sus artículos de noticias. Las URLs que vemos en nuestro navegador son las URLs amigables. Puede ser que las URLs que vienen del CMS sean otras, como /artículo?124. Y luego el CMS las hace más bonitas.
Lo interesante es que ChatGPT no tiene acceso directo a los artículos de Ecuavisa; al menos esto dice ChatGPT mismo. ChatGPT no está muy claro porque no tiene acceso a los artículos, pero dar 2 posibles opciones:
- Internamente el contenido viene de /articulo/ aunque la URL visible sea distinta.
- El robots.txt está incompleto.
En todo caso, ChatGPT parece que decide no entrar directamente a las páginas de noticias de Ecuavisa, al menos en algunos casos. Dice que las URLs amigables le dejan “puertas abiertas” para sí entrar (si quiere).
Teleamazonas
Al igual que Primicias o El Mercurio, Teleamazonas no bloquea a GPTBot, Google-Extended o CCBot. Esto significa que la IA puede leer sus noticias del día a día sin problemas.
Pero bloquean explícitamente el acceso a sus archivos antiguos:
- Disallow: /2015/ hasta Disallow: /2020/. Además, tienen una lista enorme de prohibiciones para sus franquicias de entretenimiento:
- MasterChef: Bloquean /masterchefecuador/, /MasterChef/ y /sorteo-masterchef/.
- Yo Me Llamo: Bloquean todas las versiones (/yomellamo/, /YoMeLlamo6/, /YoMeLLamo7/).
- Otros: 100 Ecuatorianos Dicen, Ahora Caigo, La Voz.
TC Televisión
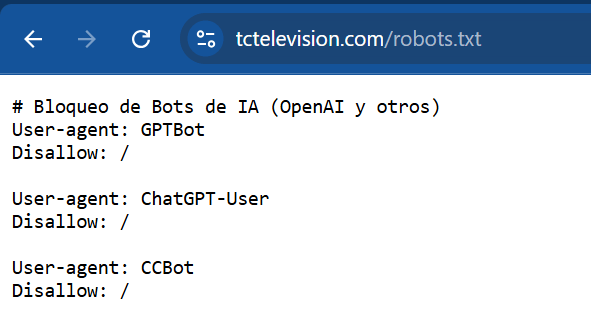
Son muy específicos al bloquear a las tres grandes «amenazas» actuales para el contenido de sus noticias:
- GPTBot: Bloquean el rastreo masivo de OpenAI.
- ChatGPT-User: Bloquean las consultas directas de usuarios que usan plugins o navegación de ChatGPT.
- CCBot: Bloquean a Common Crawl, que es la fuente de datos abierta que usan casi todos los demás modelos de IA menores.
Pero no están bloqueando Google-Extended. Así permiten que Google (Gemini) sí use su contenido, probablemente para no arriesgar su visibilidad en las AI Overviews de la búsqueda de Google.
El bloqueo vía robots.txt no es perfecto
Es importante mencionar que un disallow en el archivo robots.txt no necesariamente significa que los bots de la IA no rastreen un sitio web:
- Robots.txt solo contiene indicaciones. Los motores de búsqueda como Google y Bing respetan estas indicaciones. Pero no es obligatorio. Solo porque los motores de búsqueda tradicionales cumplen con las indicaciones no significa que la IA haga lo mismo.
- Además, la IA también toma información como títulos y meta descripciones/search snippets directamente desde Google sin visitar las páginas web de los medios de comunicación.
- Adicionalmente, existen sitios web que republican los contenidos de los medios de comunicación sin bloquear los bots de la IA.
¿Por qué algunos medios están bloqueando la IA y otros no?
La visibilidad y las citaciones en ChatGPT, Gemini y otras herramientas de la IA pueden ser buenas para los medios de comunicación. Se puede dar a conocer la marca. Y así tal vez los usuarios van a visitar directamente los sitios de Ecuavisa, El Comercio o Primicias, etc.
Además, desde la IA se puede recibir clics y así tráfico. Pero sabemos que el tráfico que llega a través de la IA es bajo. Muchos medios de comunicación necesitan tráfico porque ganan dinero con anuncios.
Justo esto es la razón por la que algunos medios de comunicación están bloqueando la IA: la IA muestra sus contenidos, pero no manda tráfico a sus sitios web.
Por esta razón, Teleamazonas muy probablemente está bloqueando el acceso de la IA a sus programas como MasterChef.
Como se puede ver en el caso de El Universo, todavía no saben bien si les ayuda bloquear la IA o si va a tener efectos negativos o tal vez ningún efecto.
Lo interesante es también que no siempre se están bloqueando todos los bots de IA. Por ejemplo, Espresso no está bloqueando Perplexity. Tal vez no lo ven como amenaza.
Resumen
- El Comercio: Fue el más restrictivo. Pero recientemente cambió su archivo robots.txt. Ya no aparecen los bots de la IA. Pero utiliza Cloudflare, así puede impedir que cualquier IA use su contenido, ya sea para responder preguntas o para entrenar modelos futuros.
- Expreso: Bloquea varios bots de la IA (OpenAI, Anthropic, Common Crawl), pero, por ejemplo no el bot de Perplexity.
- La Hora: Permite que bots de IA que funcionan como buscadores (Perplexity o el buscador de ChatGPT) los encuentren para no perder visibilidad, pero bloquea el acceso a sus archivos internos y el uso de sus noticias para entrenamiento de modelos de IA.
- TC Televisión: Bloquea directamente a los actores principales como OpenAI, pero no está bloqueando Google-Extended. Así Gemini sí puede usar su contenido.
- Teleamazonas: No bloquea la IA actual, pero protege sus programas estrella (MasterChef, Yo Me Llamo) y oculta su archivo de noticias de años anteriores (2015-2020).
- El Telégrafo: Su configuración es obsoleta. Se enfoca en bloquear bots de hace una década y buscadores rusos o chinos, ignorando por completo la existencia de ChatGPT o Gemini.
- El Universo: Tiene la lista de bloqueos escrita en su código, pero está desactivada (como comentario). Por ahora, cualquier bot de la IA puede entrar.
- Primicias y El Mercurio: Son los más abiertos. No tienen restricciones; priorizan que su contenido se difunda en cualquier plataforma y sea indexado lo más rápido posible.
- Ecuavisa: No es muy claro si quieren bloquear la IA como ChatGPT vía robots.txt.
Mientras los medios tradicionales y canales de TV (Comercio, Expreso, TC) están levantando muros en su archivo robots.txt para proteger su propiedad intelectual, los medios digitales nativos o regionales (Primicias, El Mercurio) prefieren mantener el acceso libre para maximizar su alcance. No queda muy claro qué está haciendo Ecuavisa. El Universo parece que todavía no ha decidido cómo tratar la IA.
También te puede interesar:
Rendimiento de tus páginas en la IA de Microsoft Copilot en Bing Webmaster Tools.
¿Qué partes de una página web lee ChatGPT cuando hace una búsqueda en la web?
¿Cómo saber si Google u otros motores de búsqueda pueden rastrear una página web?

Soy Robert Korntheuer y este es mi blog. Aquí escribo sobre temas relacionados con el SEO (Search Engine Optimization) como tendencias en la búsqueda local, el posicionamiento para el comercio electrónico o la relación entre las redes sociales y los principales motores de búsqueda.